只用一顆相機,
加上飛控裡的 IMU。
目標是讓無人機在沒有 GPS、地圖不明的室內與林間低空自主飛行:追捕目標、避開行人、自己穩住。不加雷射測距、不加光流模組、不加第二顆相機。最終要代表台灣參加同等級競賽,並且上真機。這個網站說明我們用了哪些機制、背後的原理,以及哪些已經驗證、哪些還沒有。
整套系統長這樣
一顆魚眼相機切成兩個視角,各做一件事;飛控裡的 IMU 負責分辨上下。所有訊號交給學生策略,它只輸出「總推力+機身轉速」,由 PX4 飛控去轉馬達。
手機上可左右滑動流程圖。CTBR=Collective Thrust and Body Rates,總推力與機身角速度。
為什麼這件事很難
一般無人機靠 GPS 知道自己在哪,靠多顆相機或測距感測器知道東西離多遠。我們把這兩樣都拿掉了。
GPS 不能用
室內收不到衛星;林間樹冠會遮擋、反射訊號。無人機必須只靠自己看到的東西判斷怎麼飛。
一顆相機量不出距離
一張照片裡,「1 公尺外的小球」和「2 公尺外的大球」看起來一樣。這叫單目尺度不可觀(monocular scale unobservable):只靠一顆相機,原理上推不出公尺。
IMU 積分會漂
IMU 量的是加速度和轉速。把加速度積分兩次可以算位置,但每一點小誤差都會被放大,幾秒內就可能漂走好幾公尺。
三件事要同時做
追捕要看前方目標、避障要知道多久會撞上、穩飛要知道哪邊是下方。全部只能用同一顆相機加飛控本來就有的 IMU。
業界怎麼解:大多是「多加感測器」
| 系統 | 用了什麼感測器 | 距離(尺度)從哪裡來 |
|---|---|---|
| Skydio | 多顆導航相機環繞機身 | 多視角立體視覺,直接算深度 |
| DJI | 全向雙目視覺+向下感測 | 雙目視差與向下感測器量距離 |
| Swift(競速) | Intel RealSense T265 追蹤相機 | T265 自帶的雙魚眼+IMU 定位 |
| MonoRace(2025 A2RL 冠軍) | 單相機+IMU | 賽門尺寸已知,由門在畫面中的大小反推公尺 |
| 本專案 | 一顆魚眼相機+飛控 IMU | 不假設任何物體尺寸;改用「任務需要的訊號」,只有煞車用到已知起飛高度 |
MonoRace 證明單相機+IMU 能贏比賽,但它依賴賽道上已知尺寸的門。森林與室內沒有這種東西。
森林場景雙機追逃近景
左邊是第三人稱畫面:藍色標記 P 是追方,粉紅 E 是逃方,黃線是追方飛過的路徑。右邊是追方機上的 RGB 畫面,追方用固定的顏色線索找目標。
誠實說明:這是模擬;追方仍用真值自身狀態(畫面標示 own state: GT);「捕獲」是以兩機中心距離小於 0.30 m 的代理判定,不是實際碰觸。這段不是森林避障驗收,只是展示場景。
第一條路:完整定位(VIO),以及我們學到的事
最直覺的做法是先把「我在哪裡」算準到公尺,再談追捕與避障。這條路叫視覺慣性里程計(VIO)。我們認真走了一段,最後決定它在這個條件下太貴。
VIO 的原理是:相機看到的特徵點在連續畫面中移動,IMU 告訴你身體怎麼轉、怎麼加速;把兩者放進同一個濾波器,互相校正,同時估出位置、速度和重力方向。我們用的是開源的 OpenVINS。
兩個除錯技巧:怎麼確定問題出在哪一環
狀態分叉
在某一個時間點,把濾波器的完整狀態複製成兩份。一份照常吃相機更新,另一份只用 IMU 往前推。兩份從同一個起點出發,唯一差別是有沒有相機更新。
結果:只用 IMU 那份的重力誤差停在 0.08–0.42°,吃相機更新那份卻在 1 秒內被拉到 1.56–4.84°。所以「初始化不準」不是主因,是後續的相機更新把狀態拉歪。
真值替換
模擬器知道每一個點在畫面上的正確位置。把管線中某一環的輸出換成真值,其他照舊。如果誤差跟著消失,問題就在那一環;如果不變,就換下一環。
把特徵追蹤的結果換成真值投影後,拉歪的情況明顯改善,證明重複條紋造成的特徵點錯配是主因之一。
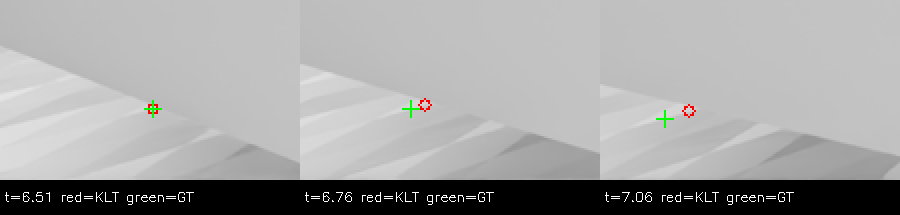
紅圈是 KLT 光流追蹤器認為的特徵點位置,綠十字是模擬器給的真實位置。牆邊附近的紋理一再重複,追蹤器分不出差別,半秒多後紅圈已沿著牆邊滑開。這類點仍能通過濾波器的檢定,就會把整個估計拉歪。
接著我們試了近十種前端篩選,想把壞點擋掉:ORB 描述子、前後向 KLT 一致性、錨點 NCC、描述子比對、特徵壽命、孔徑分數、次佳匹配比、ALIKED+LightGlue 深度學習匹配、深度一致性。每一種都在事先訂好的門檻前停下,沒有一種通過。
再拿真實無人機資料集 UZH-FPV 對照:兩組結果的初始化分別要 9.02 秒與 6.47 秒,軌跡誤差 0.249 m 與 0.720 m。舊版短窗定位測試 44 段中只過 22 段。
換個角度:向動物學習
蜜蜂、蒼蠅、遊隼都不知道自己的 GPS 座標,卻飛得比無人機好。牠們的共同點是:每個任務只取它真正需要的那一個訊號。
蜜蜂:看地面流多快
蜜蜂靠畫面流動的速度(光流)估計飛了多遠;降落時讓光流保持固定,速度就會隨高度自然變慢。
蒼蠅:先扣掉自己的轉動
蒼蠅有一對叫平衡棒的器官,像陀螺儀一樣感測轉動,先把轉動造成的畫面流動扣掉,剩下的才代表前進與障礙。
遊隼與飛彈:只看方位怎麼變
攔截時不需要知道目標多遠,只要讓目標的方位不再改變,就會撞上。這叫比例導引(proportional navigation)。
大鼠:撞到就重設
大鼠腦中的位置感也會漂,但碰到牆、角落這類可靠的地標時,會重新歸零,不讓誤差一路累積。
把同一套想法拆成四個模組
| 模組 | 任務 | 只取的訊號 | 不需要的東西 |
|---|---|---|---|
| A 追捕 | 靠近並接觸目標 | 目標方位的變化率+目標框的放大率 | 目標距離、自身位置 |
| B 避障 | 不撞上障礙物與行人 | 還剩幾秒會撞上(碰撞時間 TTC, time-to-contact) | 完整 3D 地圖 |
| C 姿態 | 知道哪邊是下方 | IMU 六軸互補濾波 | 相機 |
| D 學生策略 | 把 A/B/C 合成飛行指令 | 只吃 A/B/C 的訊號 | 自身位置(刻意不給) |
比例導引追捕
INTERACTIVE · 2D- 追方路徑
- 目標路徑
- 視線(每 0.5 秒)
- 另一種方式(淡色)
怎麼看:「直接朝目標飛」永遠對準目標現在的位置,結果繞到目標後面一路追尾。比例導引則讓轉彎速度等於 N 倍的「視線轉動速度」:視線一轉就修正,直到視線平行移動、方位不再變,這時兩者必然在前方相撞。注意比例導引只用到兩個量:方位變化率(目標在畫面裡左右移多快)和放大率(目標框變大多快,代表正在接近)。兩者都能從單一相機直接量到,完全不需要知道自己的位置,也不需要知道目標距離。N 太小(1 左右)轉得不夠,接近直接追;N 在 3–5 之間最典型。
單目深度繞柱追捕
左上是追方的第一人稱畫面,實際送進單目深度模型 Depth Anything V2(DA-V2) 估障礙物深度;右上是評分用的俯視軌跡;右下是追方自己邊飛邊建的「迷霧地圖」(暗=未知、灰=看過、棕=有障礙)。
誠實說明:繞柱路線由規則式 A* 規劃,不是學出來的;仍使用真值自身位姿與理想目標框;「捕獲」是近距(小於 0.3 m)判定,不是實際接觸。
從搜尋到接觸
一開始看不到目標:追方往地圖上「已知與未知的交界」(frontier)探索,找到後轉為追捕,最後在物理模擬中實際碰到目標。畫面包含機載 RGB、評分用俯視圖與迷霧地圖。
誠實說明:仍使用真值自身位姿與理想目標框;目標是靜止的。這段展示的是流程串得起來,不代表能抓到會逃的目標。
姿態:不用相機也知道哪邊是下方
陀螺儀短時間很準、時間一長會漂;加速度計長時間平均起來指向地心,但瞬間很吵。兩個互補,就是互補濾波。
α 接近 1:每一刻主要相信陀螺儀,讓畫面不抖;少量加入加速度計,慢慢把漂移拉回來。加上起飛前靜止 2 秒校準陀螺儀零點,就不需要相機參與姿態估計。
光流煞車:讓地面不再流動,就是停住了
往下看的相機裡,地面紋理往左流,代表機身正往右飄。把這個流動壓回零,無人機就停住。不需要知道自己在哪裡。
光流本身只有「角速度」,單位是每秒幾弧度,沒有公尺。同樣的速度,飛得越高,地面看起來流得越慢。所以只要知道離地高度,就能把光流換成公尺級的速度。我們用起飛時的已知高度當這個比例尺,這也是全系統唯一用到的「已知尺寸」。
光流煞車(flow nulling)
INTERACTIVE · SIDE VIEW + DOWNWARD CAMERA試試看:按「推一下」,機身被隨機方向推動,下視畫面的紋理開始流動(橘色箭頭)。煞車開啟時,控制器輸出與估計速度相反的加速度,幾秒內把流動壓回零。關掉煞車再推,它會一直飄。把高度調高:同樣速度下紋理變小、流得變慢,這就是為什麼一定要乘上高度。此示範為簡化模型,有加入少量量測雜訊。
為什麼要先扣掉轉動(gyro derotation)
INTERACTIVE · FORWARD CAMERA FLOW FIELD無人機一邊往前飛、一邊轉頭時,畫面上的流動是兩者相加。轉動造成的流動和距離無關,整個畫面一起平移;前進造成的流動則從前進方向的一點(擴張中心,FOE)往外放射,越近的東西流得越快,這才帶有「多久會撞上」的資訊。轉動通常大得多,會把有用的訊號蓋掉。陀螺儀直接量得到轉速,依公式把轉動那部分扣掉,就像蒼蠅的平衡棒。煞車用的下視光流也要先做這一步,否則機身一傾斜就會被誤當成在飄。
一顆魚眼當兩顆用
煞車要看正下方的地面,追捕要看正前方的目標,但我們只有一顆相機。答案是視野夠廣的魚眼,再用軟體切成兩個視角。
裝一顆 190–220° 的魚眼,往前下方傾斜
視野超過半球,同時涵蓋前方與正下方。
每一幀用 IMU 姿態「轉正」再切
機身前傾、側滾時,把切出來的視角轉回與重力對齊:前視 90° 給目標偵測器、正下方給光流煞車。兩個視角來自同一張影像、同一個時間點。
偵測加上時間確認
單張畫面的偵測可能誤判。加入「陀螺儀補償後,連續兩幀方位一致」才算看到目標,把雜訊造成的假目標擋掉。
魚眼一顆當兩顆
INTERACTIVE · EQUIDISTANT FISHEYE怎麼看:左邊是等距魚眼(equidistant)拍到的原始圓形影像:地面方格、遠方地平線,以及一個懸停的橘色目標。藍框與黃框是兩個虛擬視角在圓上用到的範圍,右邊是切出來、拉直後的畫面(黑色=超出魚眼視野)。下傾角 0° 時正下方掉到圓的邊緣,下視畫面缺一大塊;傾太多則前視被擠到邊緣、解析度變差。這裡的場景是合成的示意圖,不是模擬器畫面。
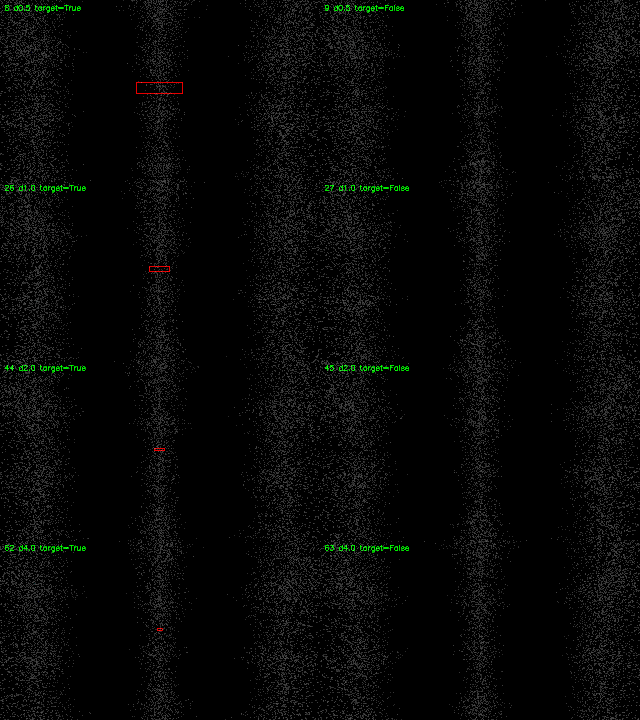
前視 90°:0.5 到 4 公尺都看得到
左欄為目標在 0.5、1、2、4 m 的前視畫面(紅框為目標位置,距離越遠越小),右欄是同距離但沒有目標的對照畫面,用來確認偵測器不會亂報。原圖相當暗,此處只做亮度提升,未做其他處理。
之前直接拿「由上往下看」的畫面找目標,結果是 0/81;改成 IMU 轉正的前視 90° 後,四個距離各 9/9。
控制:模擬裡就貼近真實飛控
模擬器裡的無人機如果「想去哪就瞬間到哪」,學到的東西上真機一定會失敗。所以我們照著 PX4 的原始碼,把真實飛控會遇到的限制搬進模擬。
策略輸出 CTBR:總推力+機身角速度
不直接控制四顆馬達,也不輸出位置。這是競速與研究界常用的介面,也是 PX4 可以直接接收的指令,上真機時不需要改格式。
推力分配與抗飽和
把「總推力+三軸轉速」換算成四顆馬達的轉速;當某顆馬達已經到上限,按 PX4 的優先順序取捨(抗飽和,anti-windup),而不是讓數字無限累積。
馬達一階延遲
真實馬達需要時間加速。模型設定時間常數 25 ms,在模擬中實測為 26 ms,兩者一致。
學習:教練看得到答案,選手看不到
強化學習裡有兩個角色:Actor 決定動作,Critic 評估動作好不好。只有 Actor 會上真機,所以只有它必須「只看感測器」。
教練:可以看真值
Critic 可以看到模擬器裡的真實位置、速度、目標距離,給出更準確的評分,讓訓練更快收斂。真機上不需要它。
選手:只吃感測器訊號
Actor 只收 A/B/C 三個模組的輸出:方位變化率、放大率、碰撞時間、光流速度、姿態。不收位置。
最怕的是真值「偷偷漏」進 Actor。我們做了逐位元隔離測試:把真值通道的數字任意竄改,檢查 Actor 的輸出是否一個位元都不變。
老師策略 vs 舊追方
左邊是舊版追方,右邊是老師策略,下方是各自的迷霧地圖與即時數據。舊追方在部分場景中進入不安全狀態(畫面標示 UNSAFE)。
誠實說明:右側是規則式老師,使用理想深度與合成目標框,不是強化學習學出來的學生成果;仍使用真值自身位姿;捕獲以距離小於 0.3 m 判定,不是實際接觸。
失敗也是成果:誠實清單
沒通過的實驗一樣寫下來。它們告訴我們哪條路不通,也讓通過的結果更可信。
純方位導引追捕
只用比例導引、不看障礙物,0/16。它不會繞柱子,視線被擋就直直撞上去;原本規劃的方法同一組場景是 14/16。
用光流估碰撞時間
第 3 版改用全解析度後,均勻場景可以過;但遮擋時會誤判正在接近,行人只占畫面一部分時又會誤判還很遠。
單目深度模型
7 個深度模型都沒有通過「通道淨空」門檻:無法可靠判斷前方縫隙夠不夠機身穿過。
VIO 手工前端篩選
ORB、前後向 KLT、NCC、描述子、深度學習匹配等近十種方法,都沒有通過事先訂的門檻(見第 02 章)。
研究紀律:讓結果經得起檢查
先登記門檻,再跑實驗
跑之前就寫下「怎樣算過」。跑完不能回頭改門檻,避免看到結果再挑一個好看的標準。
失敗全部保留
沒過的實驗和過的一樣留紀錄、留影片。影片裡的八個場景依編號全部播出,不只挑成功的。
證據加上 SHA 指紋,備份上雲
每份結果檔都算出 SHA 雜湊值(像檔案的指紋),內容改了一個位元指紋就會不同,再備份到雲端。日後任何人都能核對數字是不是當初跑出來的那份。
下一步:上真機
目前沒有任何真機飛行紀錄。上面所有數字都來自模擬或公開資料集。下一步是用最少的硬體、最保守的順序,把模擬裡的東西搬上真機。
最小硬體
六級安全測試:每一級通過才進下一級
不裝槳,只測介面
確認相機、機載電腦、飛控之間的指令與時間都對。
姿態治具
機身固定在可轉動的治具上,只驗證互補濾波與姿態控制。
受保護的單軸架
只放開一個方向,在保護下測推力與反應。
滑台光流
相機在有紋理的地面上方滑動,驗證「光流 × 高度」量到的速度。
網內綁繩
在網籠裡用繩子限制範圍,第一次真正離地。
網內短時間釋放
解開繩子,在網籠內短時間自主懸停與煞車。